Ollama の gemma4 で音声文字起こしを試す
はじめに
音声ファイルを Ollama 上の Gemma 4 に送って文字起こしできるか試してみました。
結論を先に言うと、
gemma4:e2b-mlx(MLX量子化版)は音声を受け付けず、何を送っても無視されましたgemma4:12bはaudiocapability を持っていて、そのまま文字起こしできました
同じ Gemma 4 でもタグによって音声が通ったり通らなかったりするので、その確認の過程を残しておきます。
環境
- Mac(Apple M1 Pro / メモリ 16GB)
- Ollama 0.30.7
- Python 3.9(標準ライブラリのみ。
urllibで API を叩いています)
呼び出しは Ollama の OpenAI 互換エンドポイント /v1/chat/completions を使い、音声は input_audio(base64)で渡します。Ollama ネイティブの /api/chat の audios フィールドは音声が無視されるという情報があったので、基本は OpenAI 互換のほうを使いました。
1. テスト用の音声を作る
答え合わせができるように、macOS の say で英語の短い音声を作ります。
$ say -o sample.aiff "Hello, this is a test audio for transcription. Today we have a meeting in Tokyo at three o'clock."
$ afconvert -f WAVE -d LEI16@16000 -c 1 sample.aiff sample.wav
$ afinfo sample.wav | grep -iE "duration|sample rate|channels"
2. gemma4:e2b-mlx で試す → 音声が無視される
最初に試したのは gemma4:e2b-mlx(7.1GB / nvfp4 量子化)です。
$ ollama pull gemma4:e2b-mlx
$ ollama show gemma4:e2b-mlx
ollama show の Capabilities がこうなっていました。
Capabilities
    completion
    tools
    thinking
audio も vision もありません。とりあえず音声を送ってみると、返ってきたのはこれです。
Please provide an audio file.
音声を付けたのに「音声をください」と言われます。送り方が悪いのかと思い、音声を付けない場合と付けた場合を並べて比較してみました。
[テキストのみ(音声なし)] -> 'Please provide the audio you want me to transcribe.'
[テキスト + 音声]          -> 'There is no audio provided for transcription. Please provide an audio file.'
[テキスト動作確認: PONGと返して] -> 'PONG'
音声を付けても付けなくても「音声が無い」と言われ、テキストだけの動作確認(PONG)はちゃんと通ります。つまり API もリクエスト形式も正常で、送った音声だけがモデルに届いていないということです。
念のため、ネイティブ /api/chat の audios フィールドでも送ってみましたが、同じく無視されました。
[audios-field] -> 'Please provide the audio you would like me to transcribe.'
ollama show の Capabilities に audio が無いとおり、gemma4:e2b-mlx には音声を処理する仕組みが入っておらず、どの渡し方をしても文字起こしはできませんでした。
3. gemma4:12b で試す → audio capability があって成功
次に gemma4:12b(7.6GB / q4_K_M)を試しました。Gemma 4 の 12B はエンコーダーレス設計で、専用の音声エンコーダを持たずに 16kHz の波形を直接 LLM に渡してネイティブに音声を処理できる、という構造になっています(参考: https://ai-heartland.com/llm/gemma-4-12b-open-mm/)。
$ ollama pull gemma4:12b
$ ollama show gemma4:12b
今度は Capabilities に audio が入っていました。
Capabilities
    completion
    vision
    audio
    tools
    thinking
先ほどと同じ sample.wav を input_audio で送ってみます。
import base64, json, urllib.request

b64 = base64.b64encode(open("sample.wav", "rb").read()).decode()
payload = {
    "model": "gemma4:12b",
    "messages": [{"role": "user", "content": [
        {"type": "input_audio", "input_audio": {"data": b64, "format": "wav"}},
        {"type": "text", "text": "Transcribe this audio word for word. Output only the transcription."},
    ]}],
    "stream": False,
}
req = urllib.request.Request(
    "http://localhost:11434/v1/chat/completions",
    data=json.dumps(payload).encode(),
    headers={"Content-Type": "application/json", "Authorization": "Bearer dummy"},
)
print(json.loads(urllib.request.urlopen(req).read())["choices"][0]["message"]["content"])
結果がこちらです。
ELAPSED 89.6s
REFERENCE:      Hello, this is a test audio for transcription. Today we have a meeting in Tokyo at three o'clock.
TRANSCRIPTION:  Hello, this is a test. Audio for transcription. Today we have a meeting in Tokyo at three o'clock.
8.5 秒の音声に対して、初回ロード込みで 約90秒。文字起こしの中身は、「a test. Audio」と区切りの位置が少しずれただけで、単語はすべて正しく、固有名詞の「Tokyo」も時刻の「three o'clock」も正確でした。
4. 日本語の音声でも試す
英語で動いたので、日本語の音声でも同じように試しました。say -v Kyoko(日本語音声)で次の文を読み上げ、同じく 16kHz・モノラルに変換しています。
基準テキスト: 「こんにちは。これは音声文字起こしのテストです。今日は東京で三時に会議があります。よろしくお願いします。」
プロンプトも日本語にして(「この音声を一字一句そのまま書き起こしてください。書き起こしのみ出力してください。」)、9.19 秒の jp.wav を送った結果がこちらです。
こんにちは。これは音声文字起こしのテストです。今日は東京で3時に会議があります。よろしくお願いします。
「三時」が「3時」(算用数字)になった表記揺れが 1 箇所あっただけで、それ以外は句読点まで含めて完全一致でした。日本語でもそのまま使えています。
処理時間は 20.5 秒。英語の 90 秒より速いですが、これは英語のときが初回のモデルロードを含んでいたためで、すでにモデルがメモリに乗った状態だと 9 秒の音声をこのくらいで処理できました。
まとめ
- Ollama の Gemma 4 でも、タグによって音声を処理できるものとできないものがある
gemma4:e2b-mlx(nvfp4)はollama showの Capabilities にaudioが無く、input_audio・audiosフィールドのどちらで送っても音声は無視されたgemma4:12b(q4_K_M)は Capabilities にaudioがあり、input_audioで送るだけで文字起こしできた- 英語・日本語のどちらでもほぼ正確に文字起こしできた(日本語は「三時→3時」の表記揺れが1箇所あった程度)
- 使うモデルが音声に対応しているかは、
ollama showの Capabilities にaudioがあるかどうかで判断できる - 音声は OpenAI 互換エンドポイント
/v1/chat/completionsにinput_audio(base64)で渡し、16kHz・モノラルに揃えておく - M1 Pro / 16GB での処理時間は、初回ロードを含む英語の回が約90秒、モデルが温まった日本語の回(9秒の音声)が20.5秒だった
brewで入れたClaude Codeのバージョンが古い話
brewで入れたClaude Codeのバージョンが古かったので、ネイティブインストールに切り替えました。
そのとき、なぜバージョンが追従していなかったのか不思議だったので、改めて確認してみました。
結論
brewには claude-code と claude-code@latest の2つが存在しており、最新版は claude-code@latest として公開されていました。自分が入れていた claude-code の方は最新に追従していなかった、というのが古かった理由です。
当時はhomebrew-caskのマージ履歴を確認し、最新のバージョンがマージされているのに反映されていないと思っていました。しかし、それは claude-code@latest としてのマージでした。
補足
公式で推奨されている&自動でアップデートされるので、ネイティブインストールの方が快適でおすすめです。
curl -fsSL https://claude.ai/install.sh | bash
ただ自分のタイミングでアップデートしたいが、できる限り最新に近いものを利用したい人は、brewの claude-code@latest を利用するのもありかもしれません。
Ollamaのフリープランでcloudモデルを使ってClaude Codeを動かす
Ollamaのフリープランで利用できるcloudモデルを使い、Claude Codeを動作させてみました。
glm-5.2:cloud はフリープランでは起動できない
まず glm-5.2:cloud を指定したところ、プランのアップグレードを求められて起動できませんでした。
$ ollama launch claude --model glm-5.2:cloud
  To use   glm-5.2:cloud, upgrade your Ollama plan.
gemma4:cloud なら起動できる
gemma4:cloud に変えると、そのまま起動できました。
$ ollama launch claude --model gemma4:cloud
特に追加の設定をすることもなく動作します。試しにhello worldを出力するGoのコードを作ってもらいました。
 hello worldを出力するgoのコードをmain.goとして作成してください

  Thought for 5s

⏺ Write(main.go)
Wrote 7 lines to main.go
package main

import "fmt"

func main() {
  fmt.Println("hello world")
}

main.go を作成しました。
少し重めのタスク:TODO管理システム
もう少し負荷のかかるタスクとして、TODO管理システムを作ってもらいました。
❯ TODO管理システムを作成してください。

  データを永続化する必要はなく、ブラウザでタブを開いている間操作できればいいです。
  下記内容を実施できる様にしてください
  * タスクの登録
  * タスクの編集
  * タスクの削除
  * タスクの状態管理(未着手・進行中・完了)
完成したものがこちらです。
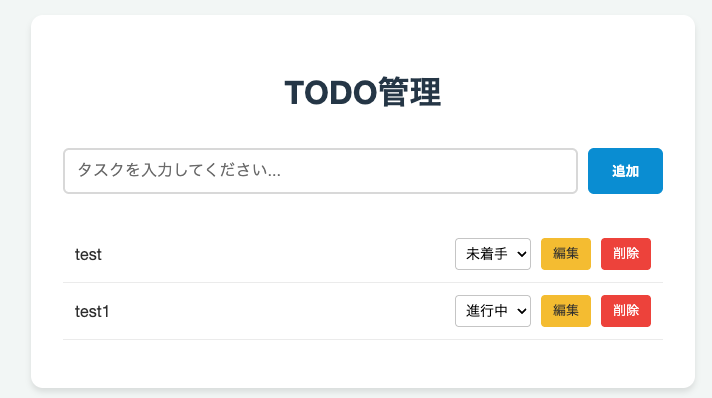
要求した仕様を満たしており、十分に動作するものが出来上がりました!
<!DOCTYPE html>
<html lang="ja">
<head>
    <meta charset="UTF-8">
    <meta name="viewport" content="width=device-width, initial-scale=1.0">
    <title>Simple TODO App</title>
    <style>
        body {
            font-family: 'Helvetica Neue', Arial, 'Hiragino Kaku Gothic ProN', 'Hiragino Sans', Meiryo, sans-serif;
            background-color: #f4f7f6;
            display: flex;
            justify-content: center;
            padding: 20px;
            color: #333;
        }
        .container {
            width: 100%;
            max-width: 600px;
            background: white;
            padding: 2rem;
            border-radius: 12px;
            box-shadow: 0 4px 6px rgba(0,0,0,0.1);
        }
        h1 {
            text-align: center;
            color: #2c3e50;
            margin-bottom: 2rem;
        }
        .input-group {
            display: flex;
            gap: 10px;
            margin-bottom: 2rem;
        }
        input[type="text"] {
            flex: 1;
            padding: 12px;
            border: 2px solid #ddd;
            border-radius: 6px;
            font-size: 16px;
            outline: none;
            transition: border-color 0.2s;
        }
        input[type="text"]:focus {
            border-color: #3498db;
        }
        button#add-btn {
            padding: 12px 24px;
            background-color: #3498db;
            color: white;
            border: none;
            border-radius: 6px;
            cursor: pointer;
            font-weight: bold;
            transition: background-color 0.2s;
        }
        button#add-btn:hover {
            background-color: #2980b9;
        }
        .todo-list {
            list-style: none;
            padding: 0;
        }
        .todo-item {
            display: flex;
            align-items: center;
            padding: 12px;
            border-bottom: 1px solid #eee;
            gap: 10px;
            transition: background-color 0.1s;
        }
        .todo-item:hover {
            background-color: #fafafa;
        }
        .todo-text {
            flex: 1;
            font-size: 16px;
        }
        .todo-text.completed {
            text-decoration: line-through;
            color: #888;
        }
        .status-select {
            padding: 6px;
            border-radius: 4px;
            border: 1px solid #ccc;
            font-size: 14px;
            cursor: pointer;
        }
        .btn-edit, .btn-delete {
            padding: 6px 12px;
            border: none;
            border-radius: 4px;
            cursor: pointer;
            font-size: 13px;
        }
        .btn-edit {
            background-color: #f1c40f;
            color: #333;
        }
        .btn-edit:hover {
            background-color: #d4ac0d;
        }
        .btn-delete {
            background-color: #e74c3c;
            color: white;
        }
        .btn-delete:hover {
            background-color: #c0392b;
        }
        .edit-input {
            flex: 1;
            padding: 6px;
            border: 1px solid #3498db;
            border-radius: 4px;
        }
    </style>
</head>
<body>

<div class="container">
    <h1>TODO管理</h1>

    <div class="input-group">
        <input type="text" id="todo-input" placeholder="タスクを入力してください...">
        <button id="add-btn">追加</button>
    </div>

    <ul class="todo-list" id="todo-list">
        <!-- タスクがここに挿入されます -->
    </ul>
</div>

<script>
    let todos = [];
    const inputEl = document.getElementById('todo-input');
    const addBtn = document.getElementById('add-btn');
    const listEl = document.getElementById('todo-list');

    const STATUSES = {
        TODO: '未着手',
        IN_PROGRESS: '進行中',
        DONE: '完了'
    };

    function render() {
        listEl.innerHTML = '';

        todos.forEach(todo => {
            const li = document.createElement('li');
            li.className = 'todo-item';

            // テキスト部分
            const textSpan = document.createElement('span');
            textSpan.className = 'todo-text' + (todo.status === 'DONE' ? ' completed' : '');
            textSpan.textContent = todo.text;

            // 編集用入力欄(編集モード時)
            const editInput = document.createElement('input');
            editInput.className = 'edit-input';
            editInput.type = 'text';
            editInput.value = todo.text;
            editInput.style.display = todo.isEditing ? 'block' : 'none';

            // ステータス選択
            const select = document.createElement('select');
            select.className = 'status-select';
            Object.entries(STATUSES).forEach(([key, label]) => {
                const option = document.createElement('option');
                option.value = key;
                option.textContent = label;
                if (todo.status === key) option.selected = true;
                select.appendChild(option);
            });
            select.onchange = (e) => updateStatus(todo.id, e.target.value);

            // 編集ボタン
            const editBtn = document.createElement('button');
            editBtn.className = 'btn-edit';
            editBtn.textContent = todo.isEditing ? '保存' : '編集';
            editBtn.onclick = () => toggleEdit(todo.id);

            // 削除ボタン
            const delBtn = document.createElement('button');
            delBtn.className = 'btn-delete';
            delBtn.textContent = '削除';
            delBtn.onclick = () => deleteTodo(todo.id);

            if (todo.isEditing) {
                li.appendChild(editInput);
                li.appendChild(select);
                li.appendChild(editBtn);
                li.appendChild(delBtn);
            } else {
                li.appendChild(textSpan);
                li.appendChild(select);
                li.appendChild(editBtn);
                li.appendChild(delBtn);
            }

            listEl.appendChild(li);
        });
    }

    function addTodo() {
        const text = inputEl.value.trim();
        if (!text) return;

        todos.push({
            id: Date.now(),
            text: text,
            status: 'TODO',
            isEditing: false
        });

        inputEl.value = '';
        render();
    }

    function updateStatus(id, newStatus) {
        const todo = todos.find(t => t.id === id);
        if (todo) {
            todo.status = newStatus;
            render();
        }
    }

    function toggleEdit(id) {
        const todo = todos.find(t => t.id === id);
        if (!todo) return;

        if (todo.isEditing) {
            // 保存処理
            const li = Array.from(listEl.children).find(child =>
                child.querySelector('.edit-input') &&
                true
            );
            const activeInput = listEl.querySelector('.edit-input');
            if (activeInput) {
                todo.text = activeInput.value;
            }
            todo.isEditing = false;
        } else {
            todo.isEditing = true;
        }
        render();
    }

    // Redefining render to include data-id for easier editing
    function renderWithIds() {
        listEl.innerHTML = '';
        todos.forEach(todo => {
            const li = document.createElement('li');
            li.className = 'todo-item';
            li.dataset.id = todo.id;

            const textSpan = document.createElement('span');
            textSpan.className = 'todo-text' + (todo.status === 'DONE' ? ' completed' : '');
            textSpan.textContent = todo.text;

            const editInput = document.createElement('input');
            editInput.className = 'edit-input';
            editInput.type = 'text';
            editInput.value = todo.text;
            editInput.style.display = todo.isEditing ? 'block' : 'none';

            const select = document.createElement('select');
            select.className = 'status-select';
            Object.entries(STATUSES).forEach(([key, label]) => {
                const option = document.createElement('option');
                option.value = key;
                option.textContent = label;
                if (todo.status === key) option.selected = true;
                select.appendChild(option);
            });
            select.onchange = (e) => updateStatus(todo.id, e.target.value);

            const editBtn = document.createElement('button');
            editBtn.className = 'btn-edit';
            editBtn.textContent = todo.isEditing ? '保存' : '編集';
            editBtn.onclick = () => {
                if (todo.isEditing) {
                    todo.text = editInput.value;
                    todo.isEditing = false;
                } else {
                    todo.isEditing = true;
                }
                renderWithIds();
            };

            const delBtn = document.createElement('button');
            delBtn.className = 'btn-delete';
            delBtn.textContent = '削除';
            delBtn.onclick = () => deleteTodo(todo.id);

            if (todo.isEditing) {
                li.appendChild(editInput);
            } else {
                li.appendChild(textSpan);
            }
            li.appendChild(select);
            li.appendChild(editBtn);
            li.appendChild(delBtn);

            listEl.appendChild(li);
        });
    }

    function deleteTodo(id) {
        todos = todos.filter(t => t.id !== id);
        renderWithIds();
    }

    addBtn.onclick = addTodo;
    inputEl.onkeypress = (e) => {
        if (e.key === 'Enter') addTodo();
    };

    renderWithIds();
    window.render = renderWithIds;

</script>
</body>
</html>
使用量
今回のタスクを含めてClaude Codeで使った gemma4:cloud の使用量はこちらです。
gemma4:cloud: 331.7k input, 10.4k output
このときのOllama側の使用量は以下の通りでした。
- Session Usage 9.4%
- Weekly Usage 3.5%
まとめ
ざっくり、今回試した量の10倍程度まではフリープランでも利用できる計算になります。
がっつり開発に使い倒すには物足りないものの、
- ちょっとしたコード生成
- 軽めのコードレビュー
といった用途であれば、フリープランでも十分実用に耐えそうです。
glm-5.2 のような上位モデルは使えませんが、個人の軽い用途でパッと無料で使う分には悪くない選択肢だと思いました。
プロプランであれば月20ドルで50倍のクラウド使用量があり、同時に3つまでクラウドモデルを利用できます。開発や実験用途でOllama Cloudを選択するのはかなりありだと感じました。
Apple container の container machine を試してみる
Apple が公開している container は、macOS 上でコンテナを動かすためのツールで、その v1.0.0 がリリースされました。
そのタイミングで新たに container machine というサブコマンドが追加されたので、調査しつつ実際に手元で動かしてみました。
container machine と container の違い
まず気になるのが、通常の「コンテナ」と「マシーン」が何によって使い分けられているのかという点です。公式ドキュメントには次のように書かれています。
Containers are typically modeled after an application. A container machine is modeled after a Linux environment.
(container-machine.md より)
コンテナは「アプリケーション」をモデルにしたもの、container machine は「Linux 環境」をモデルにしたもの、という位置づけです。
つまり、単一のアプリを動かすのがコンテナ、Linux 環境そのものが欲しいときに使うのが container machine、というイメージで捉えると分かりやすいです。手元の macOS で気軽に Linux 環境を立ち上げたいときに向いてい流様です。
メモリ管理の挙動
dockerコンテナを利用する際にメモリ周りの挙動で困ることがあったので、メモリ周りの挙動について調べてみました。 technical-overview.md には次の点が記載されています。
- 大量にメモリを割り当てても、実際に必要なメモリしか利用しない
- ただし、仮想マシン内で解放されたメモリページは、ホスト(macOS)には解放されない
割り当て自体はオンデマンドなので無駄になりにくい一方、一度仮想マシン側で使われたメモリはホストに返ってきません。そのため、コンテナを大量に起動し続けるような用途には向いていなさそうです。
インストール
インストールは、公式のリリースページからインストーラーをダウンロードして実行するだけです。
インストールが終わったら、まずシステムをスタートします。
container system start
マシーンの作成と起動
--name で名前を付けてマシーンを作成します。今回は alpine:latest をベースに dev という名前で作成しました。
container machine create alpine:latest --name dev
作成したら、シェルを起動します。
container machine run -n dev
起動すると、デフォルトでホームディレクトリがマウントされており、そのまま使える状態になっています。マシン内で行った変更は外側(ホスト)にも反映されます。ホストのファイルをそのまま触れるので、ちょっとした作業をするにはとても便利です。
デフォルトのメモリ・CPU を確認する
立ち上げたマシーンの中で、まずはデフォルトのスペックを確認してみます。
$ free -h
              total        used        free      shared  buff/cache   available
Mem:           7.9G       60.2M        7.7G       12.0K      137.5M        7.8G
Swap:             0           0           0
$ cat /proc/cpuinfo
processor    : 0
BogoMIPS    : 48.00
...
processor    : 4
BogoMIPS    : 48.00
...
デフォルトではメモリ 7.9G、CPU 5 コアが割り当てられていました。これは利用している端末のメモリ・CPU のおよそ半分にあたります。
メモリ・CPU の設定を変更する
スペックは後から変更できます。変更するときは、一度マシーンを停止してから set で設定し、再度起動します。
container machine stop dev
container machine set -n dev cpus=2 memory=4G
container machine run -n dev
変更後、改めてマシーンの中で確認してみます。
$ free -h
              total        used        free      shared  buff/cache   available
Mem:           4.0G       68.5M        3.8G       12.0K      137.9M        3.9G
Swap:             0           0           0
$ cat /proc/cpuinfo
processor    : 0
BogoMIPS    : 48.00
...
processor    : 1
BogoMIPS    : 48.00
...
メモリは 4.0G、CPU は 2 コアに変わっています。指定したとおりに反映されました。
ホームディレクトリのマウント設定を変更する
ホームディレクトリのマウントの仕方も set で変更できます。停止 → 設定変更 → 起動の流れは CPU・メモリのときと同じです。
リードオンリーでマウントする
container machine stop dev
container machine set -n dev home-mount=ro
container machine run -n dev
home-mount=ro を指定すると、ホームディレクトリがリードオンリーになり、書き込みができなくなります。ホストのファイルを誤って書き換えたくないときに使えます。
マウントしない
container machine stop dev
container machine set -n dev home-mount=none
container machine run -n dev
home-mount=none を指定すると、ホームディレクトリがマウントされなくなります。ホストから切り離した環境を作成できます。
ホームディレクトリのマウント先に注意
最後に、ハマりやすいポイントを一つ。
ホームディレクトリのマウント先は次のパスになっています。
/Users/{ユーザー名}
一方で、シェルで cd を実行したときに移動するディレクトリは次のパスです。
/home/{ユーザー名}
つまり、cd で移動する先(/home/{ユーザー名})と、ホストのホームディレクトリがマウントされている場所(/Users/{ユーザー名})が別になっていました。
ホストのファイルを触りたいときは /Users/{ユーザー名} に移動する必要があるので注意が必要です。
まとめ
- container machine は「Linux 環境」をモデルにしたもので、macOS 上で手軽に Linux 環境を立ち上げられます
- 仮想マシン内で解放したメモリはホストに返らないため、大量起動の用途には向いていなさそうです
- CPU・メモリ・ホームディレクトリのマウント方法は、停止してから
setで変更できます - ホームディレクトリのマウント先(
/Users/{ユーザー名})とcdの移動先(/home/{ユーザー名})が異なる点には注意が必要です
macOS で気軽に Linux 環境が欲しいときの選択肢として、覚えておくと便利そうです。
LLM Checkerでローカルに最適なLLMを調べて、コーディングエージェントとして動かしてみた
はじめに
今回は LLM Checker というツールで「自分のマシンで実際に動くLLM」を調べ、Ollamaの新機能 ollama launch を使って、おすすめされたモデルをコーディングエージェントとして動かしてみました。
結論を先に言うと、今回の環境(M1 Pro / 16GB)では実用レベルでは動かせませんでした。その過程を、やってみた記録として残しておきます。
1. LLM Checkerとは
LLM Checker は、自分のPCのハードウェアをスキャンして「どのLLMがローカルで動かせるか」を教えてくれるCLIツールです。
主な特徴は以下のとおり。
- CPU / GPU / RAM / アクセラレーションバックエンド(Metal・CUDA・ROCmなど)を自動検出
- 数万件規模のモデル情報(Hugging Face / Ollama / GPT4All)と自分のハードウェアを照合
- Quality / Speed / Fit / Context の4軸でモデルを0〜100点にスコアリング
- コーディング・推論・マルチモーダルなどカテゴリ別におすすめを提示
- そのままコピペで使える
ollama pullコマンドまで出してくれる
Node.js製でネイティブ依存がないため、導入も手軽です。
# インストールせずに実行
npx llm-checker hw-detect      # ハードウェアを検出
npx llm-checker recommend      # おすすめモデルを表示
2. 実行結果
実際に recommend を実行した結果がこちらです。
SYSTEM INFORMATION
╭──────────────────────────────────────────────────
│ CPU: M1 Pro (10 cores, 2.4GHz)
│ Architecture: Apple Silicon
│ RAM: 16GB
│ GPU: Apple M1 Pro
│ Backend: Apple Metal
│ VRAM: 8GB shared (Integrated)
│ Dedicated GPUs: None
│ Integrated GPUs: Apple M1 Pro
│ Hardware Tier: MEDIUM LOW
╰
 INTELLIGENT RECOMMENDATIONS BY CATEGORY
╭─────────────────────────────────────────────────────────────────
│ Hardware Tier: MEDIUM LOW | Models Analyzed: 10799
│ Optimization: BALANCED | Runtime: AUTO
│ Source: Multi-source registry
│
│ BEST OVERALL: yi
│    Command: ollama pull yi:6b
│    Score: 89/100 | Category: general
│    Quantization: Q4_K_M
│    Runtime: ollama | Source: ollama
│    Fine-tuning: QLoRA
│
│ Coding (Coding):
│    qwen2.5-coder (7B)
│    Score: 78/100 | Pulls: 15,000,000
│    Quantization: Q4_K_M
│    Runtime: ollama | Source: ollama
│    Fine-tuning: QLoRA
│    Command: ollama pull qwen2.5-coder:7b
│
│ Reasoning (Reasoning):
│    deepseek-coder-v2 (16B)
│    Score: 90/100 | Pulls: 2,500,000
│    Quantization: Q4_K_M
│    Runtime: ollama | Source: ollama
│    Fine-tuning: No FT
│    Command: ollama pull deepseek-coder-v2:16b
│
│ Multimodal (Multimodal):
│    Qwen/Qwen2.5-VL-7B-Instruct (7B)
│    Score: 88/100 | Pulls: 8,081,428
│    Quantization: Q4_K_M
│    Runtime: vllm | Source: huggingface
│    Fine-tuning: QLoRA
│    Command: hf download Qwen/Qwen2.5-VL-7B-Instruct
│
│ Creative (Creative):
│    Kijai/WanVideo_comfy (5B)
│    Score: 87/100 | Pulls: 2,267,846
│    Quantization: Q4_K_M
│    Runtime: vllm | Source: huggingface
│    Fine-tuning: QLoRA
│    Command: hf download Kijai/WanVideo_comfy FastWan/Wan2_2-TI2V-5B-FastWanFullAttn_bf16.safetensors
│
│ Talking (Chat):
│    Kijai/WanVideo_comfy (5B)
│    Score: 87/100 | Pulls: 2,267,846
│    Quantization: Q4_K_M
│    Runtime: vllm | Source: huggingface
│    Fine-tuning: QLoRA
│    Command: hf download Kijai/WanVideo_comfy FastWan/Wan2_2-TI2V-5B-FastWanFullAttn_bf16.safetensors
│
│ Reading (Reading):
│    llama3.2 (3B)
│    Score: 86/100 | Pulls: 67,700,000
│    Quantization: Q6_K
│    Runtime: ollama | Source: ollama
│    Fine-tuning: QLoRA
│    Command: ollama pull llama3.2:3b-instruct-q6_K
│
│ General (General):
│    yi (6B)
│    Score: 89/100 | Pulls: 1,200,000
│    Quantization: Q4_K_M
│    Runtime: ollama | Source: ollama
│    Fine-tuning: QLoRA
│    Command: ollama pull yi:6b
│
╰
読み解いてみると、
- Hardware Tier: MEDIUM LOW … M1 Pro / 16GB(VRAMは8GB共有)は「ミドルロー」帯という判定。
- 10,799モデルを分析した上で、カテゴリ別にベストを提示してくれています。
- BEST OVERALL は
yi:6b(89点)。 - そして今回の目的である Coding カテゴリのおすすめが
qwen2.5-coder (7B)(78点)。
カテゴリ別のおすすめをまとめるとこんな感じです。
| カテゴリ | モデル | スコア | コマンド |
|---|---|---|---|
| Best Overall | yi (6B) | 89 | ollama pull yi:6b |
| Coding | qwen2.5-coder (7B) | 78 | ollama pull qwen2.5-coder:7b |
| Reasoning | deepseek-coder-v2 (16B) | 90 | ollama pull deepseek-coder-v2:16b |
| Reading | llama3.2 (3B) | 86 | ollama pull llama3.2:3b-instruct-q6_K |
| General | yi (6B) | 89 | ollama pull yi:6b |
コーディング用途なので、おすすめされた qwen2.5-coder:7b を使ってみることにします。
3. Ollamaを活用する
ここで活躍するのが、最近Ollamaに追加された ollama launch コマンドです。
これ一発で Claude Code / OpenCode / Codex / Droid といったコーディングエージェントを、ローカル(またはクラウド)のモデルで起動できます。環境変数やconfigファイルの設定が不要なのが嬉しいポイントです。
4. Claude Codeで試す
まずはClaude Codeから。
ollama launch claude --model qwen2.5-coder:7b
そして、シンプルなリクエストを投げてみます。
リクエスト
hello worldを出力するgoのコードをmain.goとして作成してください
レスポンス
 {"name": "Write", "arguments": {"file_path":
  "{ディレクトリパス}/main.go", "content": "package
  main\n\nimport "fmt"\n\nfunc main() {\n\tfmt.Println("hello world")\n}"}}
コード自体は正しく生成できています。しかし、本来であれば Write ツールが実行されて main.go が作成されるはずのところ、ツール呼び出し用のJSONがテキストとしてそのまま出力されるだけで、実際のファイル作成までは至りませんでした。
5. OpenCodeで試す
気を取り直して、今度はOpenCodeで試します。
ollama launch opencode --model qwen2.5-coder:7b
リクエスト(同じもの)
hello worldを出力するgoのコードをmain.goとして作成してください
レスポンス
touch main.go

echo 'package main

import "fmt"

func main() {
    fmt.Println("hello world")
}' > main.go
OpenCodeでは「こういうコマンドを実行すればいいよ」という提案は出してくれるものの、こちらも実際には main.go には書き出されませんでした。
6. 原因を調べる ―― なぜツール呼び出しが「テキスト」になるのか
Claude Code の画面を介さず、Ollama の API を直接叩いて切り分けてみました(/api/chat に tools 付きでリクエスト)。
curl -s http://localhost:11434/api/chat -d '{
  "model": "qwen2.5-coder:7b",
  "stream": false,
  "messages": [
    {"role": "user", "content": "hello worldを出力するgoのコードをmain.goとして作成してください"}
  ],
  "tools": [
    {"type": "function", "function": {
      "name": "Write",
      "description": "Write content to a file at the given path",
      "parameters": {"type": "object",
        "properties": {"file_path": {"type": "string"}, "content": {"type": "string"}},
        "required": ["file_path", "content"]}
    }}
  ]
}'
結果は message.tool_calls が null。代わりに message.content のほうに、```json で囲まれたツール呼び出しJSONがそのまま入っていました(中身は次の通り)。
{
  "name": "Write",
  "arguments": {
    "file_path": "/path/to/main.go",
    "content": "package main\n\nimport \"fmt\"\n\nfunc main() {\n\tfmt.Println(\"hello world\")\n}"
  }
}
原因はこれでした。Ollama はモデルのテンプレートに従って、ツール呼び出しを <tool_call></tool_call> タグで囲んだ形式としてパースします。ところが qwen2.5-coder 7B はタグを使わず、必ず ```json のコードブロックで囲んで出力するため、Ollama がパースできず、構造化されないまま「ただのテキスト」になっていた、というわけです。
これは公式の qwen2.5-coder:7b / qwen2.5-coder:14b、tool 対応版の hhao/qwen2.5-coder-tools でも同じでした(14B はコードブロックは付けないものの、タグも付けない裸のJSONを出すため、やはりパースされず)。参考までに、llama3.1:8b は何も手を加えなくても API レベルで構造化された tool_calls を返したので、これは qwen2.5-coder 固有の問題だと分かります。
7. Modelfileを書き換えて直す
システムプロンプトの書き換え(ツール名は直るが…)
hhao/qwen2.5-coder-tools のシステムプロンプトには、create_file や view_file といった Cline 用のツール名がハードコードされていました。そのせいで、こちらが渡した Write ではなく create_file を勝手に呼ぼうとします。
そこでシステムプロンプトを「提供されたツールだけを使う」よう書き換えると、ツール名は正しく Write を使うようになりました。ただし ```json で囲む癖は直らず、tool_calls は null のまま。システムプロンプトの書き換えだけでは不十分でした。
テンプレートの書き換え(APIレベルでは解決)
発想を逆にして、モデルが必ず出す ```json 形式に、テンプレート側を合わせることにしました。Modelfile のテンプレートで、ツール呼び出しの描画を <tool_call></tool_call> から ```json フェンスに変更します。
これで Ollama が ```json ブロックをツール呼び出しとしてパースするようになり、message.tool_calls に構造化された Write 呼び出しが返ってきました。
[{"function": {"name": "Write",
   "arguments": {"file_path": "/path/to/main.go", "content": "..."}}}]
/api/chat だけでなく、Claude Code が使う /v1/chat/completions(OpenAI互換)でも、finish_reason: tool_calls で同じく構造化されて返ることを確認しました。
8. しかし Claude Code 実機では API エラー
ところが、この書き換えたモデルを実際に Claude Code で起動すると、
ollama launch claude --model qwen2.5-coder-cc:v2
リクエストを投げた瞬間に、次のエラーが出て動きませんでした。
✻ API error · Retrying in 0s · attempt 1/10
API を直接叩くと通るのに、ollama launch 経由の実機ではエラー。ここはまだ越えられていません。
9. 別モデル(qwen3.5:4b)では最後まで動いた
モデルを変えて qwen3.5:4b で試すと、今度は Claude Code のループが最後まで動きました。main.go を作成し、go run でエラーが出ると自分で直して、最終的に hello world を出力するところまで到達します。
⏺ 我来为你创建一个 main.go 文件,它会在运行时输出 Hello World。

⏺ Write(main.go)
  ⎿  package main
      func main() {
        _ = fmt.Println("hello world")
      }

⏺ Bash(go run main.go)
  ⎿  Error: Exit code 1
     ./main.go:5:6: undefined: fmt

⏺ Update(main.go)        ← fmt の import を追加して自己修正

⏺ Bash(go run main.go)
  ⎿  hello world
ツールの実行(Write / Bash / Update)が動き、コンパイルエラーを見て自分で修正までしています。Claude Code × ローカルLLM の仕組み自体はちゃんと動くことが確認できました。
ただし実用となると厳しく、
- 応答が中国語になる
- 最初に
fmtを import せずに_ = fmt.Println(...)と書くなどコーディングミスをする - 1回の応答に約2分かかるなど遅い
といった具合で、常用できる品質ではありませんでした。
まとめ
- LLM Checker で M1 Pro / 16GB で動くモデルを調べ、コーディング用途のおすすめ
qwen2.5-coder:7bをollama launch経由で Claude Code / OpenCode から使ってみた。 - 当初はツール呼び出しが実行されず、JSONがテキストとして出るだけだった。原因は、Ollama が期待する
<tool_call>形式と、qwen2.5-coder が出す```json形式の不一致。 - システムプロンプトの書き換えではツール名しか直らず、テンプレートを
```json形式に合わせることで、API レベルではツール呼び出しを構造化できた。 - ただしその書き換えたモデルは、
ollama launch claudeの実機ではAPI error · Retryingが出て動かなかった。 - 一方
qwen3.5:4bでは Claude Code のループが最後まで動作(ファイル作成 → エラー → 自己修正 → 実行)。統合の仕組み自体は機能することが分かったが、中国語応答・コーディングミス・遅さで実用は厳しい。
Claude Code の if 付き hook は「解析できない Bash コマンド」でも発火する
Claude Code の hooks には、if フィールドで発火条件を絞り込む機能があります。「特定のコマンド実行時だけ hook を動かしたい」といった用途にぴったりの機能ですが、実際に使ってみると、本来の意図とはまったく関係ないコマンドの実行でも hook が発火することがあります。
この記事では、その挙動がドキュメントにどう書かれているかを確認した上で、発火のきっかけをログに記録する hook を作り、どのようなコマンドで発火するのかを実験してみます。
きっかけ:無関係なコマンドで hook が動いていた
特定のコマンドの実行時だけ動くよう、if フィールドで条件を絞った hook を設定していたところ、何の関係もないコマンドの実行時にも hook が動いていることに気づきました。
最初は設定ミスを疑いましたが、調べてみるとこれは仕様でした。
ドキュメントの記載
hooks ガイドの「if フィールドでツール名と引数でフィルタリングする」には、次のように書かれています。
Hook プロセスは Bash コマンドが
git *にマッチするときにのみ生成されます。または、コマンドが解析するには複雑すぎるときです。
Hooks リファレンスの「共通フィールド」にも同様の記述があります。
コマンドが解析するには複雑すぎる場合、いずれかのサブコマンドがマッチすると、またはいつでもフックが実行されます。
つまり if のフィルタは、コマンドが解析できない場合にはパターンに関係なく hook を実行する(fail-open)設計になっています。
英語版ドキュメントにはさらに踏み込んだ記述があり、フィルタが best-effort であること、確実な許可・拒否の強制には hook ではなく permission システムを使うべきことが明言されています(日本語版には現時点でこの推奨文はありません)。
The filter also fails open, running your hook regardless of pattern, when the Bash command cannot be parsed. Because the filter is best-effort, use the permission system rather than a hook to enforce a hard allow or deny.
なお、if フィールド自体は Claude Code v2.1.85 以降で利用できます。日本語ガイドの注記にある通り、それ以前のバージョンは if を無視し、マッチャーに一致したすべての呼び出しで hook を実行します。
実験:発火のきっかけをログに残す
では、実際にどのようなコマンドで fail-open が起きるのかを確かめてみます。
検証環境は次の通りです。
- Claude Code 2.1.170
- macOS
- jq 1.7.1
hook の設定
プロジェクトの .claude/settings.json に、PreToolUse イベントの hook を設定します。if には、あえてコマンド名より詳細なパターン Bash(git push *) を指定します。
{
  "hooks": {
    "PreToolUse": [
      {
        "matcher": "Bash",
        "hooks": [
          {
            "type": "command",
            "if": "Bash(git push *)",
            "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/log-hook-trigger.sh",
            "timeout": 10
          }
        ]
      }
    ]
  }
}
ログ出力スクリプト
hook は stdin で次のような JSON を受け取ります。
{
  "session_id": "abc123",
  "transcript_path": "/path/to/transcript.jsonl",
  "cwd": "/Users/you/project",
  "permission_mode": "default",
  "hook_event_name": "PreToolUse",
  "tool_name": "Bash",
  "tool_input": { "command": "echo $(date)" },
  "tool_use_id": "toolu_01abc..."
}
ここでひとつ注意点があります。このペイロードには「なぜ hook が発火したのか」を示すフィールドがありません。パターンにマッチしたのか、解析できずに fail-open したのかは、hook 側からは直接分からないのです。
そこで、スクリプト側でコマンド文字列から発火理由を推定し、次の3分類でログに残すことにします。
pattern-match— コマンドが実際にgit pushにマッチしているfail-open/substitution-or-variable—$()・バッククォート・変数を含むため発火したと推定fail-open/unparseable-or-complex— どちらにも該当しないのに発火している。つまり解析失敗によるフォールバックと推定
スクリプト全体は次の通りです(.claude/hooks/log-hook-trigger.sh に保存し、chmod +x で実行権限を付与します)。
#!/bin/bash
#
# PreToolUse hook (if: "Bash(git push *)") から呼ばれ、
# 発火のきっかけとなったペイロードをログに記録するスクリプト。

set -u

# settings.json の "if" に書いたパターンと同期させておくこと
IF_PATTERN='Bash(git push *)'

LOG_DIR="${CLAUDE_PROJECT_DIR:-.}/.claude/hooks/logs"
LOG_FILE="${LOG_DIR}/hook-trigger.jsonl"
mkdir -p "$LOG_DIR"

# stdin から hook ペイロード(JSON)を受け取る
INPUT=$(cat)

COMMAND=$(printf '%s' "$INPUT" | jq -r '.tool_input.command // ""')

# 発火理由の推定
if printf '%s' "$COMMAND" | grep -Eq '(^|[;&|[:space:]])git[[:space:]]+push([[:space:]]|$)'; then
  REASON="pattern-match"
elif printf '%s' "$COMMAND" | grep -Eq '\$\(|`|\$\{?[A-Za-z_]'; then
  REASON="fail-open/substitution-or-variable"
else
  REASON="fail-open/unparseable-or-complex"
fi

# JSONL で1行追記
printf '%s' "$INPUT" | jq -c \
  --arg timestamp "$(date '+%Y-%m-%dT%H:%M:%S%z')" \
  --arg if_pattern "$IF_PATTERN" \
  --arg estimated_reason "$REASON" \
  '{
    timestamp:        $timestamp,
    if_pattern:       $if_pattern,
    estimated_reason: $estimated_reason,
    session_id:       .session_id,
    hook_event_name:  .hook_event_name,
    tool_name:        .tool_name,
    tool_use_id:      .tool_use_id,
    command:          .tool_input.command,
    cwd:              .cwd,
    raw_payload:      .
  }' >> "$LOG_FILE"

# exit 0 = ツール実行をブロックしない(観察用 hook なので常に許可)
exit 0
なお、hook スクリプトは stdin に JSON を流せば単体でテストできます。設定を反映する前に動作確認しておくと安心です。
echo '{"session_id":"test","hook_event_name":"PreToolUse","tool_name":"Bash","cwd":".","tool_input":{"command":"echo $(date)"},"tool_use_id":"t1"}' \
  | .claude/hooks/log-hook-trigger.sh
実験結果
Claude Code を再起動して設定を反映し(/hooks で hook が認識されているか確認できます)、Claude にさまざまなコマンドを実行させてみました。結果は次の通りです。
| 実行コマンド | 発火 | ログ上の推定理由 |
|---|---|---|
ls |
❌ | —(解析成功・不一致) |
wc -l <file> |
❌ | —(解析成功・不一致) |
git push -h |
✅ | pattern-match |
echo $(date) |
✅ | fail-open/substitution-or-variable |
echo `date` |
✅ | fail-open/substitution-or-variable |
echo $HOME |
❌ | —(発火せず) |
while read -r l <&3; do echo done-reading; break; done 3</etc/hosts |
✅ | fail-open/unparseable-or-complex |
実際のログ(抜粋)は次のようになります。
{ "estimated_reason": "pattern-match",                      "command": "git push -h" }
{ "estimated_reason": "fail-open/substitution-or-variable", "command": "echo $(date)" }
{ "estimated_reason": "fail-open/unparseable-or-complex",   "command": "while read -r l <&3; do echo done-reading; break; done 3</etc/hosts" }
結果から分かること
注目したいポイントが3つあります。
1. git push と無関係な echo $(date) で hook が発火している
これが fail-open の挙動です。$() の中身が実行時まで分からないため、「git push が含まれるかもしれない」として安全側に倒して発火しています。バッククォートでも同様でした。
2. echo $HOME は発火しなかった
少し意外な結果でした。引数位置の単純な変数展開は解析可能と判断されるようで、発火しません。一方で $() やバッククォートは発火するので、「展開結果が新たなコマンドになり得るか」で線引きされている印象です。ただしフィルタは best-effort な実装なので、この境界はバージョンによって変わる可能性があります。
3. $ を一切含まない複雑なコマンドでも発火した
最後の while read ... 3</etc/hosts はコマンド置換も変数も含んでいませんが、hook が発火しました。これがまさにドキュメントの言う「コマンドが解析するには複雑すぎる場合」の発火です。リダイレクト付きのループ構文は、サブコマンドへの分解を諦めて fail-open になるようです。
まとめ:if は頻度削減の道具であり、フィルタの正確性は当てにしない
実験から分かる通り、if フィールドは「マッチしたときだけ確実に発火する」フィルタではありません。hook プロセスの生成回数を減らすパフォーマンス最適化としては有用ですが、if を通過した時点で条件を満たしていることを前提にした設計はできません。
したがって、hook スクリプト側では、本当に処理したい対象がコマンドに含まれているかを必ず再チェックする必要があります。公式ドキュメントの例にもある通り、tool_input.command を自分で検査するのが基本形です。
#!/bin/bash
# .claude/hooks/block-rm.sh
COMMAND=$(jq -r '.tool_input.command')

if echo "$COMMAND" | grep -q 'rm -rf'; then
  jq -n '{
    hookSpecificOutput: {
      hookEventName: "PreToolUse",
      permissionDecision: "deny",
      permissionDecisionReason: "Destructive command blocked by hook"
    }
  }'
else
  exit 0  # no decision; normal permission flow applies
fi
このスクリプト内のチェックは、if: "Bash(rm *)" を付けても付けなくても必須です。if はあくまで「明らかに無関係な呼び出しで hook プロセスを起動しない」ための絞り込みであり、発火した呼び出しが条件を満たしている保証はないためです。
さらに一歩進めると、英語版ドキュメントが明言している通り、確実な許可・拒否の強制が目的なら hook ではなく permission システム(permissions.deny など)を使うべきです。整理すると次のような使い分けになります。
ifフィールド:hook の実行頻度を減らすための best-effort な絞り込み- hook スクリプト内の再チェック:fail-open で発火した場合の誤動作防止
- permission システム:確実に強制したい許可・拒否ルール
また、fail-open で意図しないタイミングに hook が走り得る以上、hook スクリプトは冪等で軽量に保ち、観察・通知用途であれば exit 0 で終了して通常の許可フローを妨げない作りにしておくのが安全です。
if 付きの hook を「条件付き実行」だと思って使うと、今回のように無関係なコマンドでの発火に戸惑うことになります。「発火候補の絞り込み」程度に捉えて、最終判断はスクリプト側で行う。この前提で設計すれば、if フィールドは hook のオーバーヘッドを減らす便利な機能として活用できます。
Cコンパイラを作る-その3
以下のサイトを参考にCコンパイラを書いていきます.エラーが出たところとかをメモがわりに残していきながらやっていきます. www.sigbus.info
僕の現状の実装 github.com
STEP12
if else while forなどの予約語が増えててきたので以下のように配列を用意してそこから一致するものがあれば予約語,なければ変数になるようにしました.
char *reserve_word[] = {
     "==",
     "!=",
     "<=",
     ">=",
     "if",
     "else",
     "while",
     "for"
 };

 int get_reserved_len(char *p) {
     for (int i = 0; i < 8; i++) {
         if (memcmp(p, reserve_word[i], strlen(reserve_word[i])) == 0) {
             return strlen(reserve_word[i]);
         }
     }
     return 0;
 }
 int len = get_reserved_len(p);
 if (len != 0) {
       cur = new_token(TK_RESERVED, cur, p, len);
        p += len;
       continue;
 }
パース部分に関しては正直ごちゃごちゃになってしまいましたが,一応動作はするような形になりました.構文木等を気にせずとりあえず動作すればいい精神で書いてしまった部分があるので後々リファクタリングしたいです.
STEP13
ブロックに関しては,ブロックが終了するまでステートメントノードをつなげるような形にしました.コード生成時に最初まで遡ってから順に出力していくことで順番が担保できると思ってます.ブロックに含まれる式のベクタとかが正直よくわからなかったのですが,現状それっぽく動いてるのでよしとします.
 Node *block() {
     Node *node = stmt();
     if (check("}")){
         consume("}");
         return node;
     }
     return new_node(ND_BLOCK, node, block());
 }
